В 2019 году приложение DeepNude наделало шуму: оно раздевало фото женщин с помощью нейросети. Результат был, мягко говоря, жутким — размытые текстуры, неестественные цвета, артефакты на каждом втором фото. Приложение закрыли через три дня после запуска. Прошло семь лет — и сегодня ИИ для раздевания генерирует фотореалистичные изображения за 25 секунд, которые сложно отличить от реальных фото. Как технология прошла этот путь? Разбираемся.
Эта статья — для тех, кому интересна не только кнопка «Загрузить фото», но и то, что за ней стоит. Мы разберём нейросеть для раздевания от А до Я: какие алгоритмы используются, на чём обучаются модели, почему одни сервисы лучше других и куда движется технология.
От DeepNude до 2026 — краткая история ИИ-раздевания
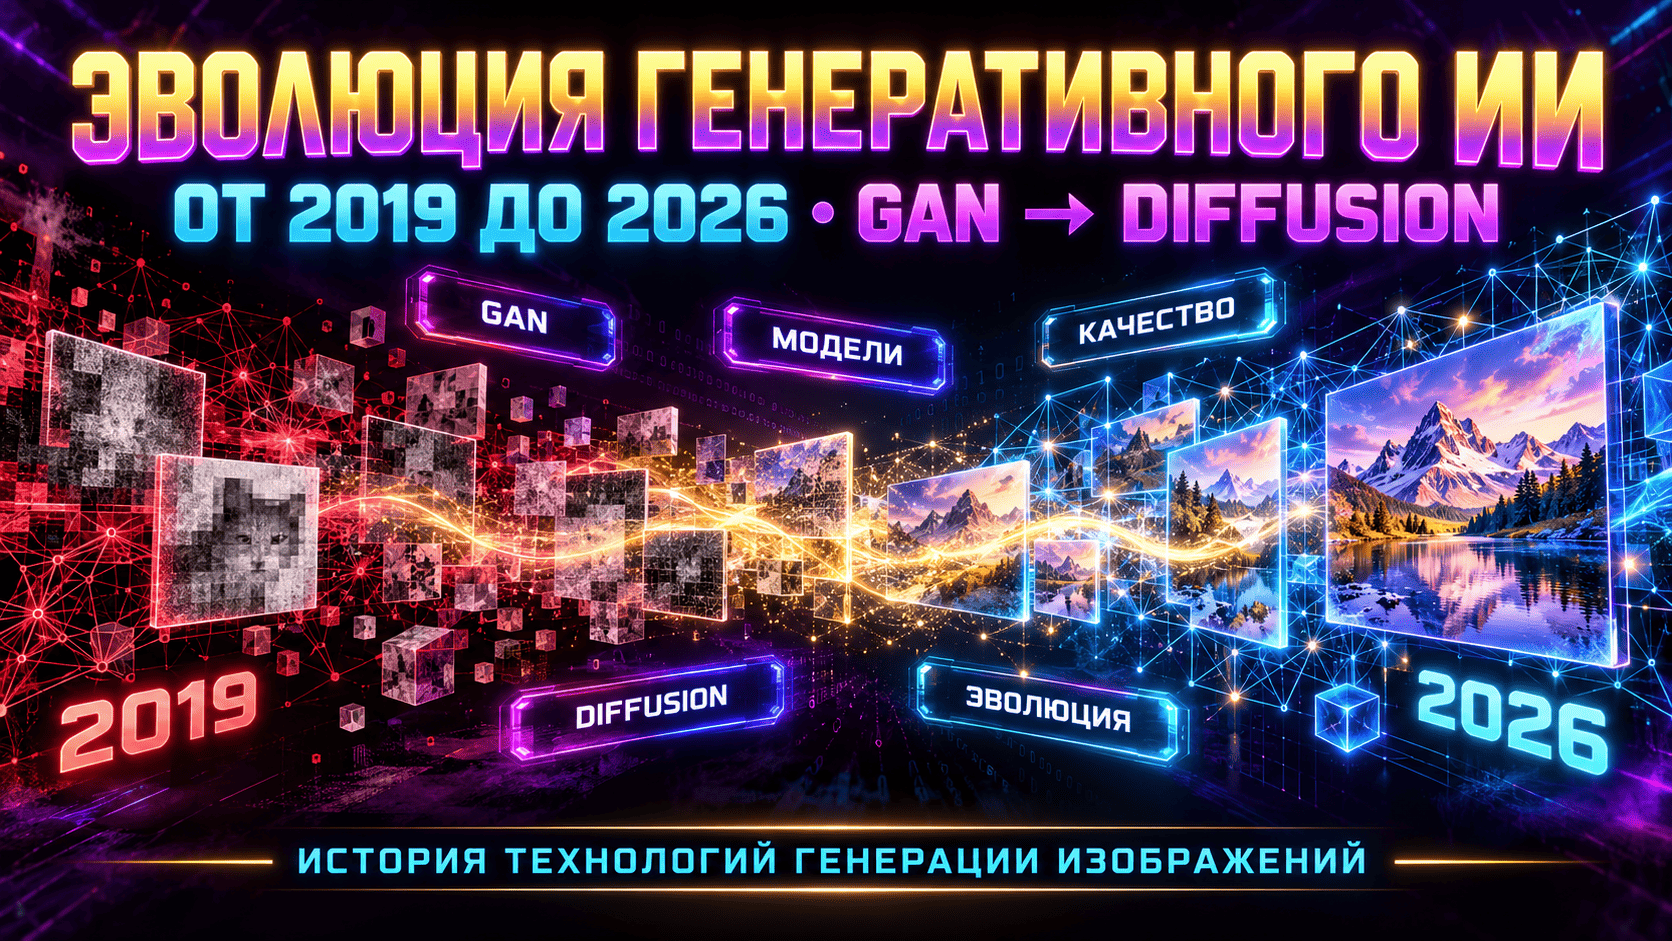
История ИИ раздевания — это, по сути, история развития генеративных нейросетей. Вот ключевые вехи:
2019 — DeepNude. Первый публичный сервис. Использовал GAN (Generative Adversarial Network) первого поколения — pix2pix. Качество — ужасное: размытые текстуры, неправильные пропорции, работал только с женскими фото в определённых позах. Закрыт через три дня из-за общественного резонанса. Но код утёк — и десятки форков появились в даркнете.
2020-2021 — Эпоха GAN-клонов. Десятки Telegram-ботов на основе украденного кода DeepNude. Качество чуть лучше оригинала, но всё ещё плохое: артефакты, однотипные результаты, работа только с определённым типом фото. Большинство ботов — мошенники, собирающие деньги и фото.
2022-2023 — Революция Stable Diffusion. Появление открытой модели Stable Diffusion изменило всё. Diffusion-модели оказались принципиально лучше GAN для генерации изображений: более реалистичные текстуры, правильные тени, меньше артефактов. Энтузиасты создали первые пайплайны «одетое фото → раздетое фото» на базе Stable Diffusion. Качество выросло на порядок.
2024 — Профессиональные сервисы. Появились первые легальные веб-сервисы с нейросетью для раздевания: оптимизированные пайплайны, облачные GPU, удобные интерфейсы. Качество достигло уровня «хорошо, но заметно при детальном рассмотрении».
2025-2026 — Фотореализм. Мультимодельные пайплайны (сегментация + карта тела + генерация + paste-back + сглаживание) дают результаты, которые при беглом взгляде неотличимы от реальных фотографий. Обработка — от 10 до 30 секунд. Технология доступна массово через веб-интерфейсы.
GAN vs Diffusion Models — два поколения технологии
Чтобы понять почему ИИ для раздевания так скакнул в качестве, нужно понять разницу между двумя поколениями моделей.
GAN (Generative Adversarial Network) — «соревнование двух сетей».
Принцип: две нейросети соревнуются друг с другом. Генератор создаёт изображение, дискриминатор пытается определить — настоящее оно или сгенерированное. Генератор учится обманывать дискриминатор, дискриминатор учится ловить подделки. Со временем оба становятся лучше.
Проблемы GAN для задачи раздевания: нестабильность обучения (модель может «застрять» и генерировать однотипные результаты), mode collapse (все результаты похожи друг на друга), плохая работа с деталями (текстуры кожи, мелкие тени). DeepNude и его клоны использовали именно GAN — поэтому результаты были посредственными.
Diffusion Models — «управляемый шум».
Принцип радикально другой. Модель обучается на двух процессах: добавление шума к изображению (прямой процесс) и удаление шума (обратный процесс). При генерации модель начинает с чистого шума и постепенно «очищает» его в осмысленное изображение, руководствуясь условиями (маска одежды, карта тела, текстура кожи с оригинала).
Почему Diffusion лучше для раздевания: стабильное обучение, разнообразие результатов, отличная работа с текстурами и мелкими деталями, возможность точного кондиционирования (управление результатом через маску и карту тела). Stable Diffusion — самая известная реализация, лежащая в основе современных нейросетей для раздевания.
Как нейросеть «понимает» одежду и тело — сегментация и карта тела
Сама по себе модель генерации (Stable Diffusion) не умеет «раздевать». Ей нужны точные инструкции: что на фото является одеждой, какие пропорции у тела, откуда падает свет. Эти инструкции готовят вспомогательные модели.
Сегментация одежды (SegFormer). Нейросеть анализирует каждый пиксель фото и классифицирует его: «это рукав», «это юбка», «это открытая кожа», «это волосы», «это фон». На выходе — «маска» одежды, которая точно показывает границы того, что нужно заменить. Точность современных моделей сегментации — 95-98% на стандартных фото. Ошибки случаются при: прозрачной одежде, одежде в цвет кожи, множественных слоях (куртка поверх рубашки поверх футболки).
Карта тела (MediaPipe / DensePose). Вторая модель строит «скелет» — определяет положение ключевых точек тела: плечи, локти, бёдра, колени. Продвинутые модели (DensePose от Meta) идут дальше — строят полную 3D-карту поверхности тела, определяя как каждая точка соотносится с анатомией. Это критически важно для правильных пропорций.
Анализ освещения. Отдельный модуль определяет направление и характер света на фото: откуда падает свет, насколько он жёсткий или мягкий, какая цветовая температура. Это нужно чтобы тени на сгенерированном теле совпадали с тенями на оригинале. Без этого результат выглядит «наклеенным».
На чём обучают модели — откуда берутся данные
Любая нейросеть для раздевания обучена на данных. Какие именно данные используются — один из главных факторов качества.
Парные датасеты. Идеальный вариант — пары фотографий одного и того же человека: в одежде и без. Такие данные собираются из легальных источников: фотосессии моделей с их согласия, стоковые фото с открытой лицензией, синтетические пары (3D-рендер человека с одеждой и без). Качество модели прямо пропорционально количеству и разнообразию парных данных.
Аугментация данных. Для увеличения объёма используется аугментация: изменение освещения, поворот, масштабирование, наложение разных типов одежды на одно и то же тело. Один реальный пример превращается в десятки вариаций.
Файн-тюнинг на задачу. Базовая модель Stable Diffusion обучена на миллиардах изображений — она «знает» как выглядит человеческое тело вообще. Файн-тюнинг (дообучение) на парных датасетах «одежда → без одежды» адаптирует эти знания к конкретной задаче. Чем качественнее файн-тюнинг — тем лучше результат.
Размер датасета имеет значение. DeepNude (2019) был обучен на ~10 000 пар. Современные модели — на сотнях тысяч пар с разнообразием типов тел, поз, освещения, одежды. Именно объём данных — одна из главных причин скачка качества.
Почему одни сервисы лучше других — разница в пайплайнах
Все современные раздеваторы используют Stable Diffusion (или его форки). Но качество отличается разительно. Почему? Потому что «модель генерации» — это лишь один из компонентов. Итоговое качество определяется пайплайном — цепочкой всех моделей и алгоритмов.
Бюджетный пайплайн (плохие сервисы): одна модель Stable Diffusion «из коробки» без файн-тюнинга. Маска одежды — простая (пороговая бинаризация). Карта тела — отсутствует или примитивная. Paste-back — грубый, без сглаживания границ. Результат: заметные артефакты, «наклеенный» вид, неправильные пропорции.
Продвинутый пайплайн (хорошие сервисы): файн-тюненная Stable Diffusion + SegFormer для сегментации + MediaPipe/DensePose для карты тела + анализ освещения + paste-back с blending + цветокоррекция + шумоподавление. Четыре-шесть моделей работают последовательно. Результат: фотореалистичный, с правильными тенями и пропорциями.
На ImgFree Undress используется многоступенчатый пайплайн из четырёх нейросетей — именно поэтому обработка занимает 25 секунд (а не 5): каждый этап требует вычислительных ресурсов, но каждый вносит свой вклад в итоговое качество.
Пределы технологии — что ИИ раздевает хорошо, а что нет
Даже лучшие современные нейросети для раздевания имеют ограничения. Вот честный список того, что технология пока не умеет:
- Групповые фото. Несколько человек в кадре — нейросеть путает контуры тел, накладывает элементы одного человека на другого. Решение: обрезать фото до одного человека перед загрузкой.
- Тяжёлая многослойная одежда. Зимняя куртка, пуховик, бесформенный балахон — ИИ не может точно определить пропорции тела под толстым слоем ткани. Результат будет «угаданным», а не точным.
- Сложные позы. Руки перекрывают торс, скрещенные ноги, поза сидя с поджатыми коленями — всё это затрудняет построение карты тела. Чем проще поза — тем лучше результат.
- Низкое разрешение. Фото 200×300 пикселей — нейросеть не «видит» деталей, маска одежды получается неточной, результат размытый. Минимум для хорошего результата — 600×800.
- Нестандартные типы тел. Модели обучены на «среднестатистических» телах. Очень полные, очень худые, необычные пропорции — результат может быть менее точным.
Эти ограничения технологические, а не принципиальные. С каждым годом модели обучаются на более разнообразных данных и пайплайны усложняются — то, что было ограничением вчера, завтра перестанет им быть.
Куда движется технология — прогноз на 2027
Основываясь на текущих тенденциях, вот что можно ожидать от ИИ для раздевания в ближайший год:
Видео-обработка в реальном времени. Уже сейчас существуют прототипы, которые обрабатывают видео покадрово. К 2027 скорость достигнет real-time: загружаешь видео — получаешь обработанное видео за несколько минут. Качество отдельных кадров будет близко к статичным фото.
Интерактивное управление. Возможность указывать: «оставь эту часть одежды», «измени позу», «добавь другое освещение». Вместо «чёрного ящика» — управляемый процесс с возможностью итеративной доработки.
3D-реконструкция. Вместо плоского 2D-изображения — полная 3D-модель, которую можно вращать. Технология NeRF (Neural Radiance Fields) уже позволяет строить 3D из нескольких фото. Объединение с раздеванием — следующий логический шаг.
Улучшение работы со сложными случаями. Многослойная одежда, нестандартные позы, групповые фото — всё это станет менее проблематичным по мере роста датасетов и усложнения пайплайнов.
Заключение
ИИ для раздевания — одна из самых динамично развивающихся областей генеративного ИИ. За семь лет технология прошла путь от жуткого DeepNude до фотореалистичных результатов. За этим стоит эволюция от GAN к Diffusion Models, рост датасетов в десятки раз и усложнение пайплайнов от одной модели до цепочки из четырёх-шести.
Если хотите увидеть на что способна современная нейросеть для раздевания — попробуйте ImgFree Undress на imgfree.io. Три бесплатных обработки без регистрации, результат за 25 секунд. Технология, которая ещё пять лет назад казалась фантастикой — теперь доступна в один клик.